AI企画の相談で、かなりの頻度で聞くセリフがあります。
「まずデータを集めて、AIに学習させて、予測できるようにしたいんです」
気持ちは分かります。AI活用の記事や事例で目にするのは、だいたいこの形だからです。データを貯めて、モデルを作って、予測する。でも中小企業でこの企画が動き出すことは、ほとんどありません。今日はその理由と、じゃあ何から始まるのかを、うちの採用を例に書きます。
「データを集めて予測」が中小企業で死ぬ理由
理由は単純で、学習に足るデータが貯まっていないからです。
予測モデルの類いは、過去の事例がたくさんあって初めて機能します。ところが中小企業の採用は、年に数人。10年分を集めてもサンプルは数十件で、しかもその間に事業も求める人物像も変わっている。他の業務でも事情は同じです。取引先の数、案件の数、クレームの数。大企業の「データ資産」とは桁が3つ4つ違う。
ここで「じゃあ、まずデータを貯めるところから」と言い出すと、企画は死にます。成果が出るのが数年後になり、その間ずっとコストだけが出続ける。誰も待てません。
でも、これは「中小企業にAIは無理」という話ではありません。選ぶ技術を間違えているだけです。
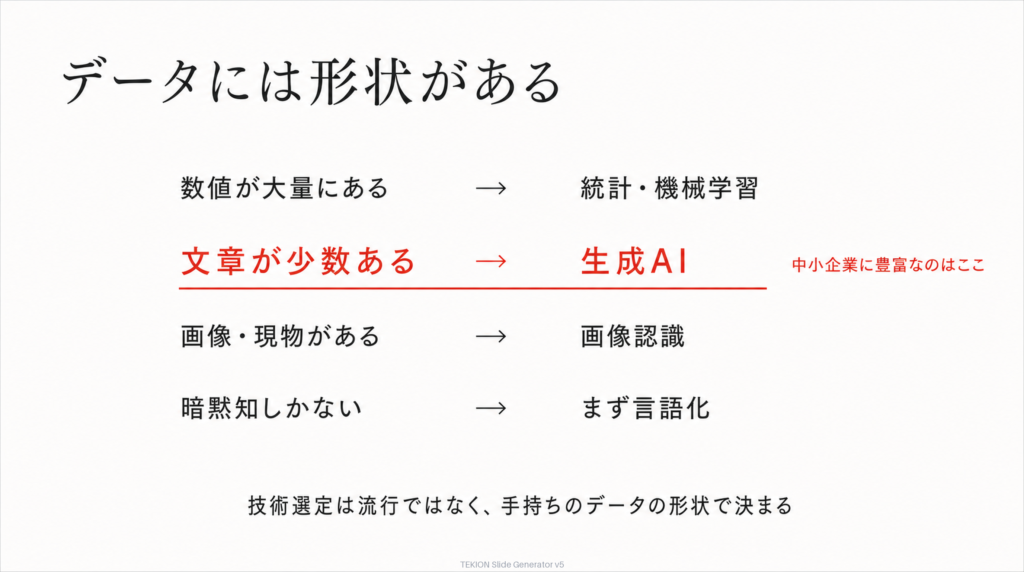
データには形状がある
技術選定の前に、自社にあるデータを形状で棚卸しします。だいたい4種類に分かれます。
- 数値が貯まっている:売上、在庫、アクセスログ。件数が多く、構造化されている
- 文章が少数ある:提案書、議事録、応募書類、問い合わせメール。件数は少ないが、一つひとつが濃い
- 画像・現物:図面、写真、現場の様子
- 暗黙知:ベテランの頭の中にだけあり、まだ何の形にもなっていない
そして、形状ごとに合う技術が違います。
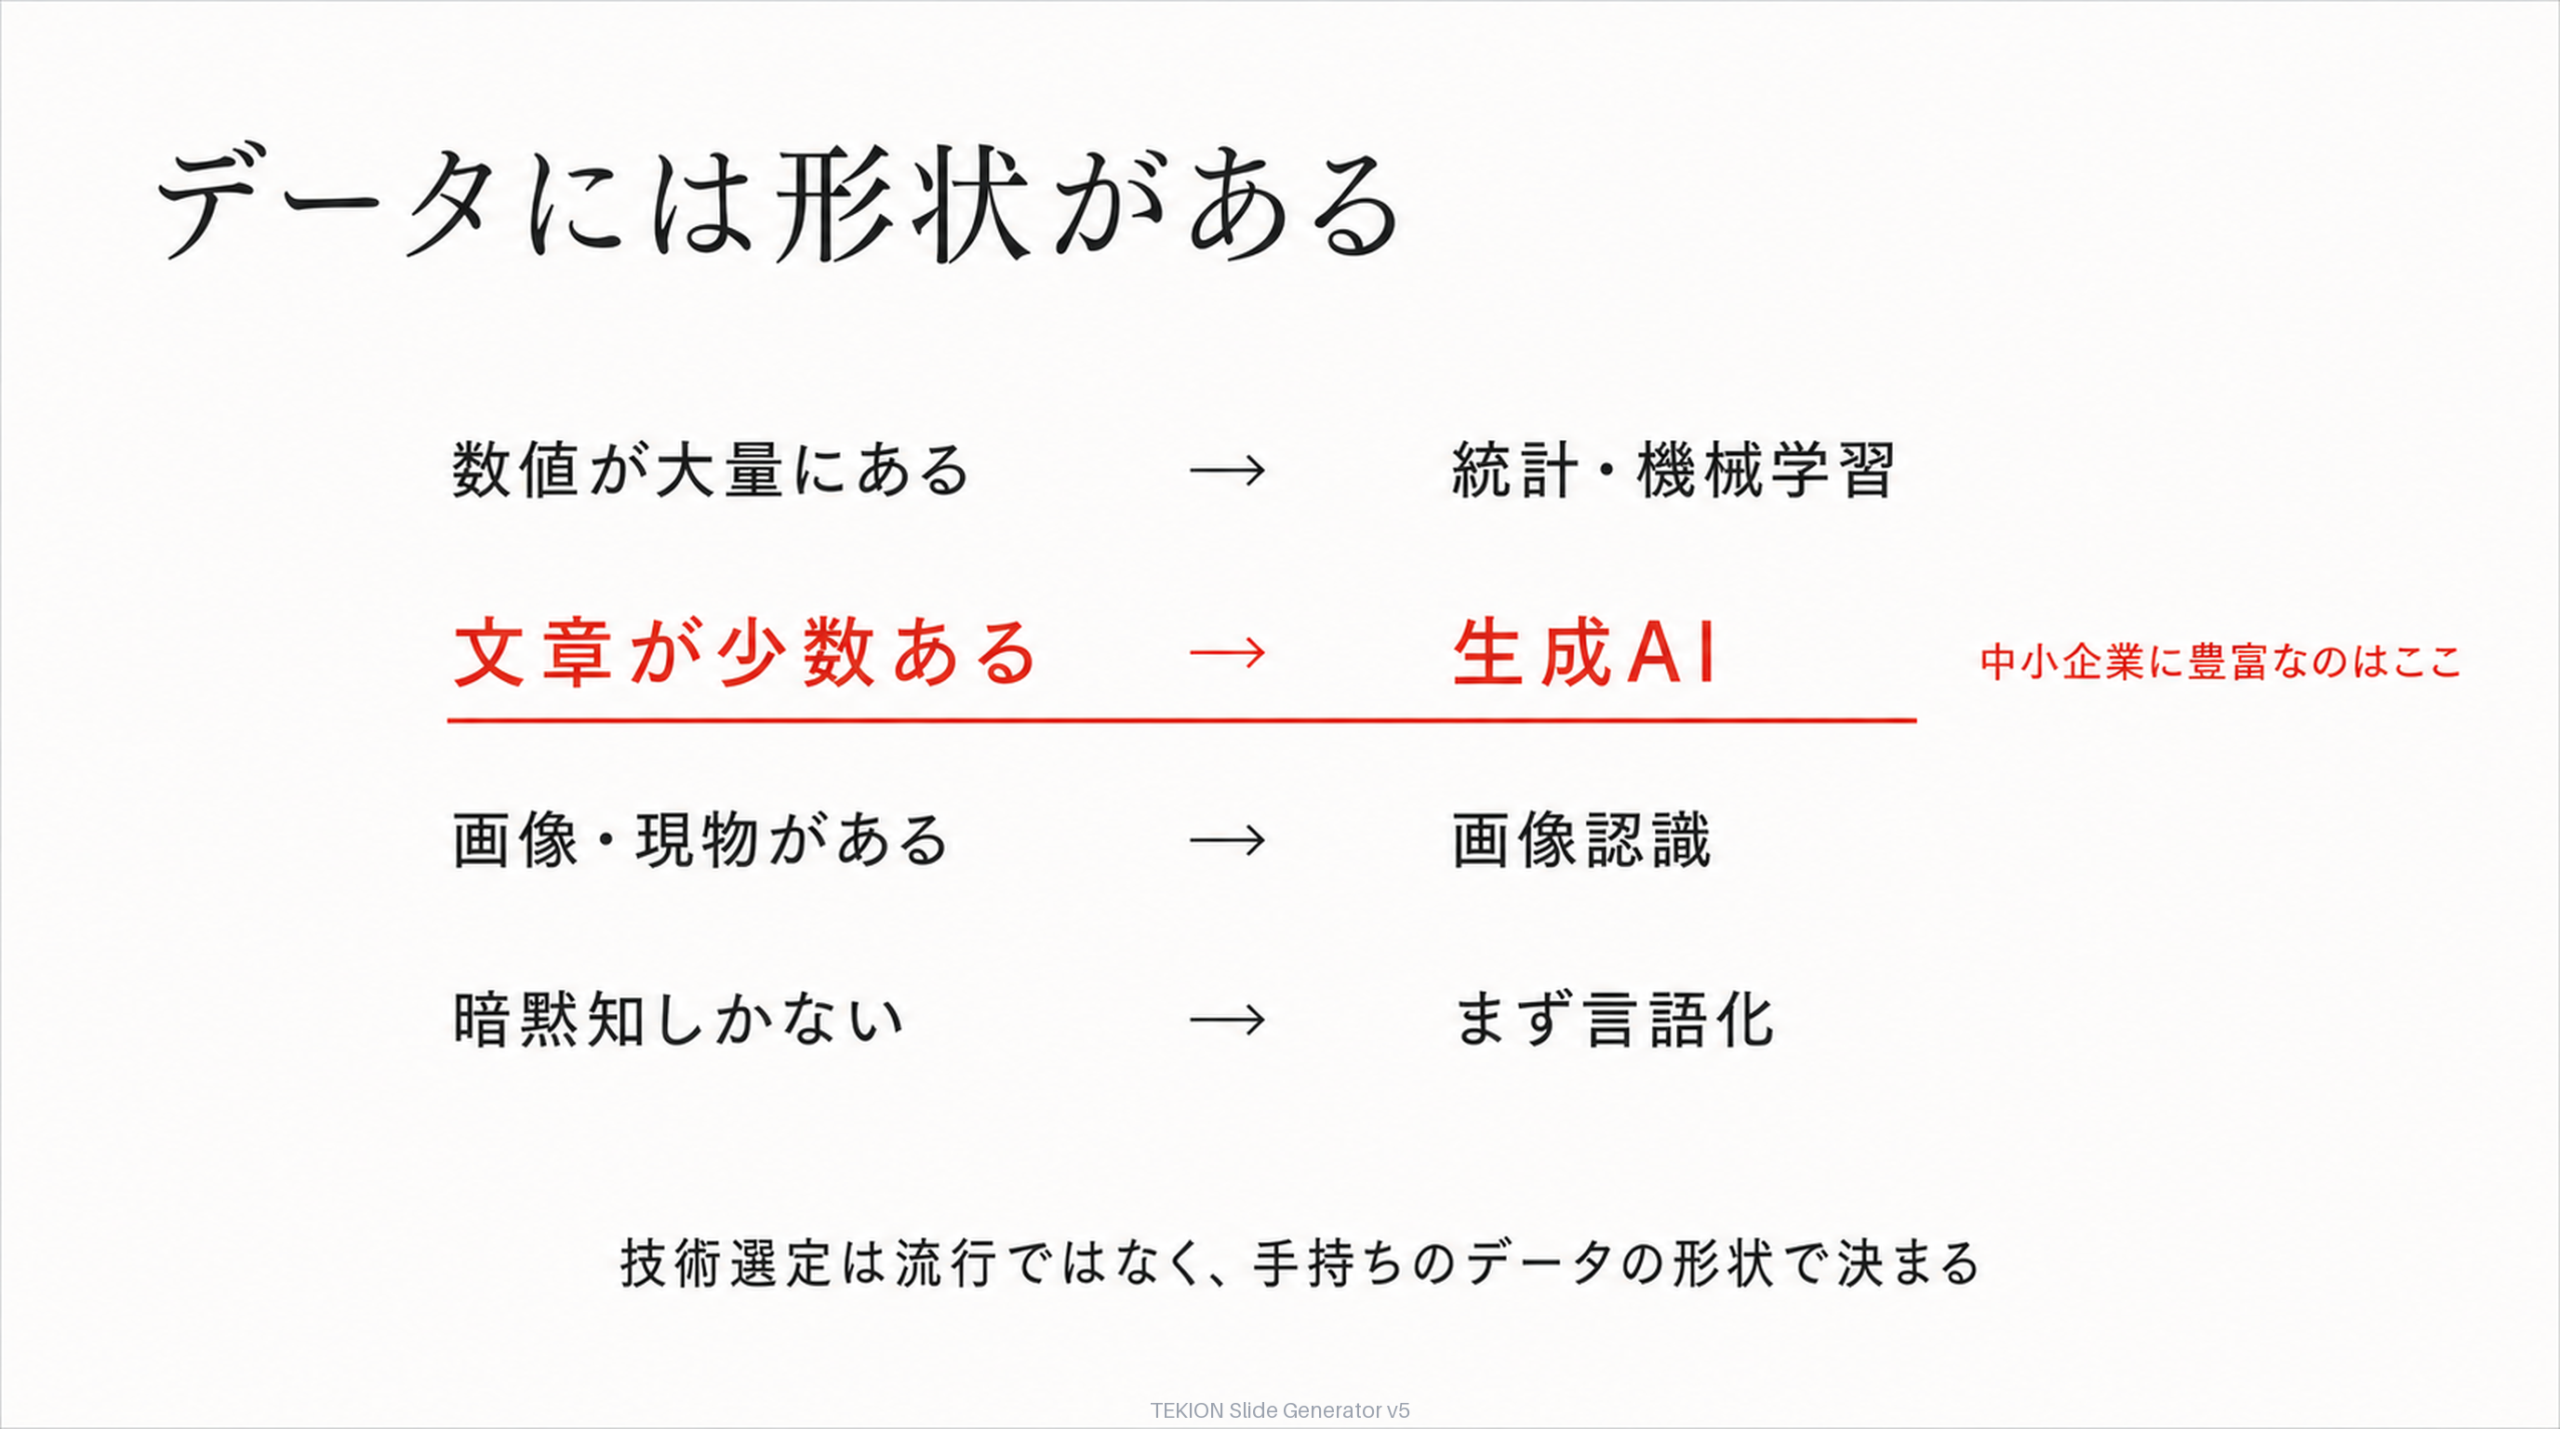
中小企業の実情は、ほとんどの場合「1が少なく、2と4が豊富」です。数値は貯まっていないが、濃い文章と、人の頭の中の判断基準はある。だとすれば、技術選定の答えはほぼ自動的に決まります。少数の濃い文章を読ませるなら生成AI。生成AIは大量のデータで自社学習させなくても、一件の文章を深く読む使い方ができる。ここが従来のAIとの決定的な違いで、中小企業にとって生成AIが「初めて使えるAI」である理由です。
うちの採用も、この消去法でした。過去の採用データは学習に足りない。手元にあるのは、評価テストの回答という自由記述と、応募書類という自己申告。少数の濃い文章が2種類。だから生成AIで読む。流行だから選んだのではなく、データの形状から逆算したらそこに着地した、という順番です。
2つの文章を「突き合わせる」という設計
技術が決まったら、次は何をさせるかの設計です。ここにうちの採用AI化の核心があります。
評価テストの回答を単体で採点させることも、応募書類を単体で要約させることもできます。でも、それでは書類選考の高速化にしかならない。前回の言葉でいえば第1層(時間)の効果です。
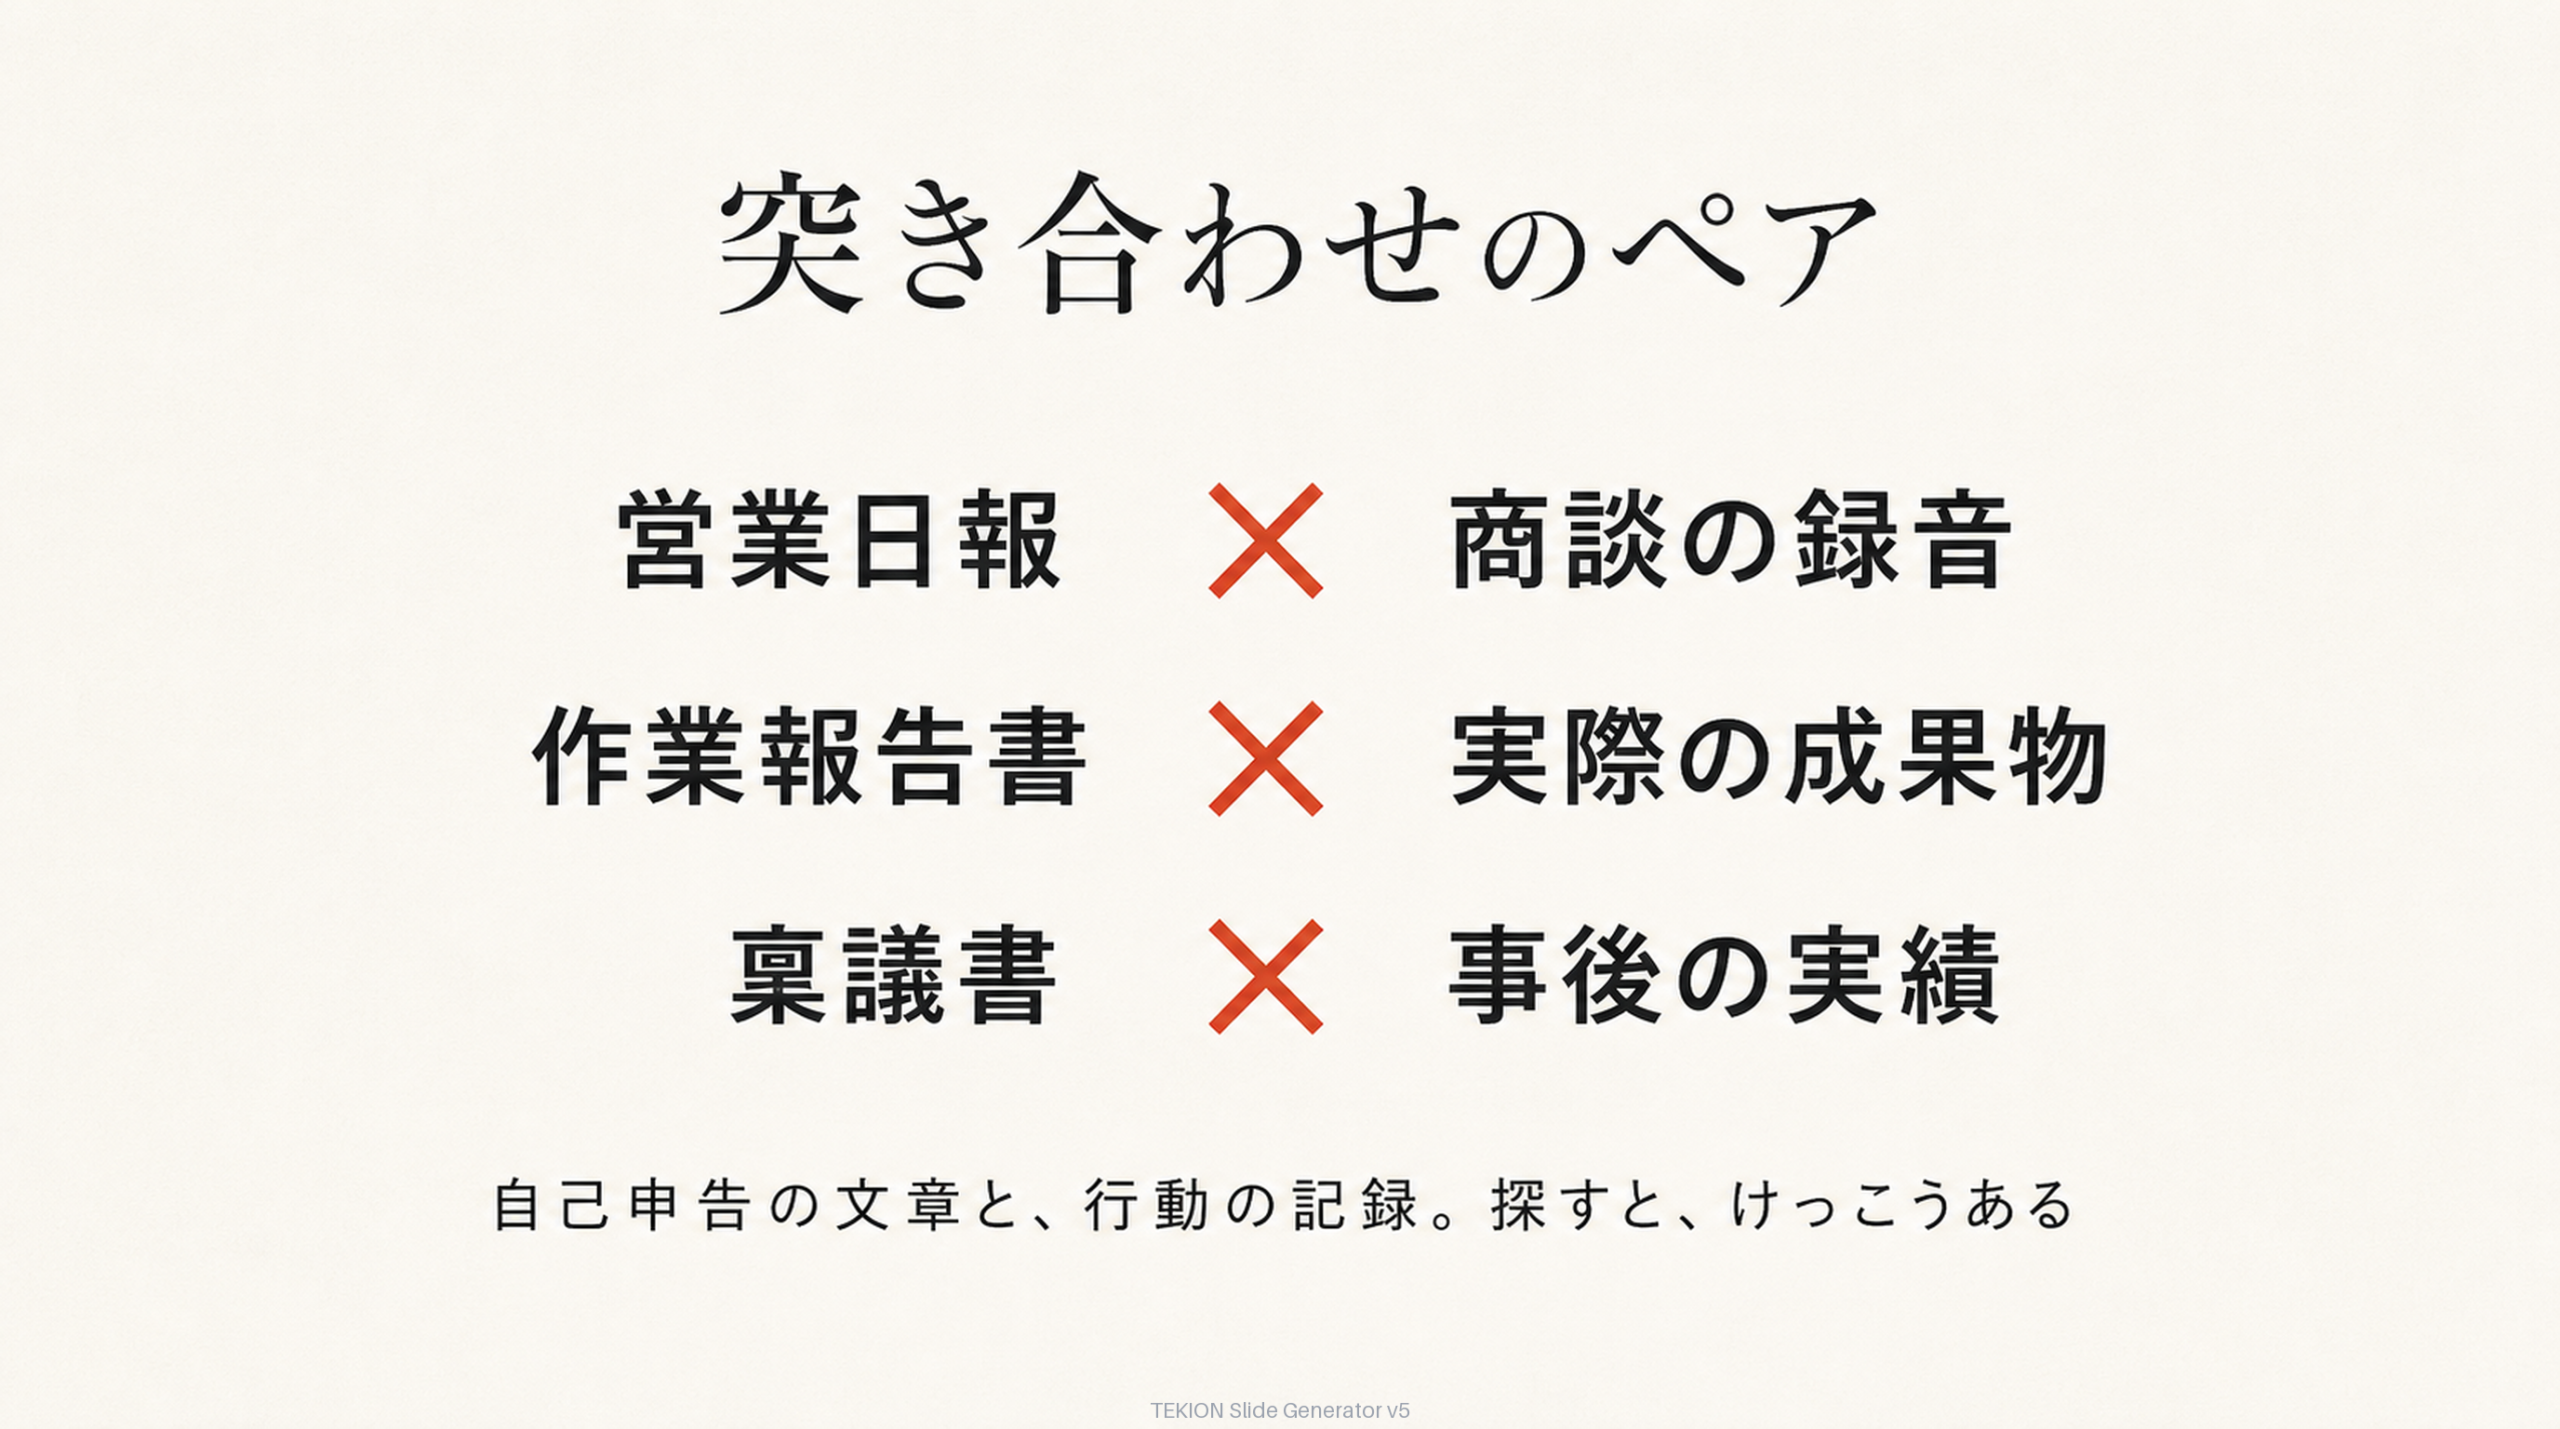
うちがやっているのは、2つを突き合わせることです。
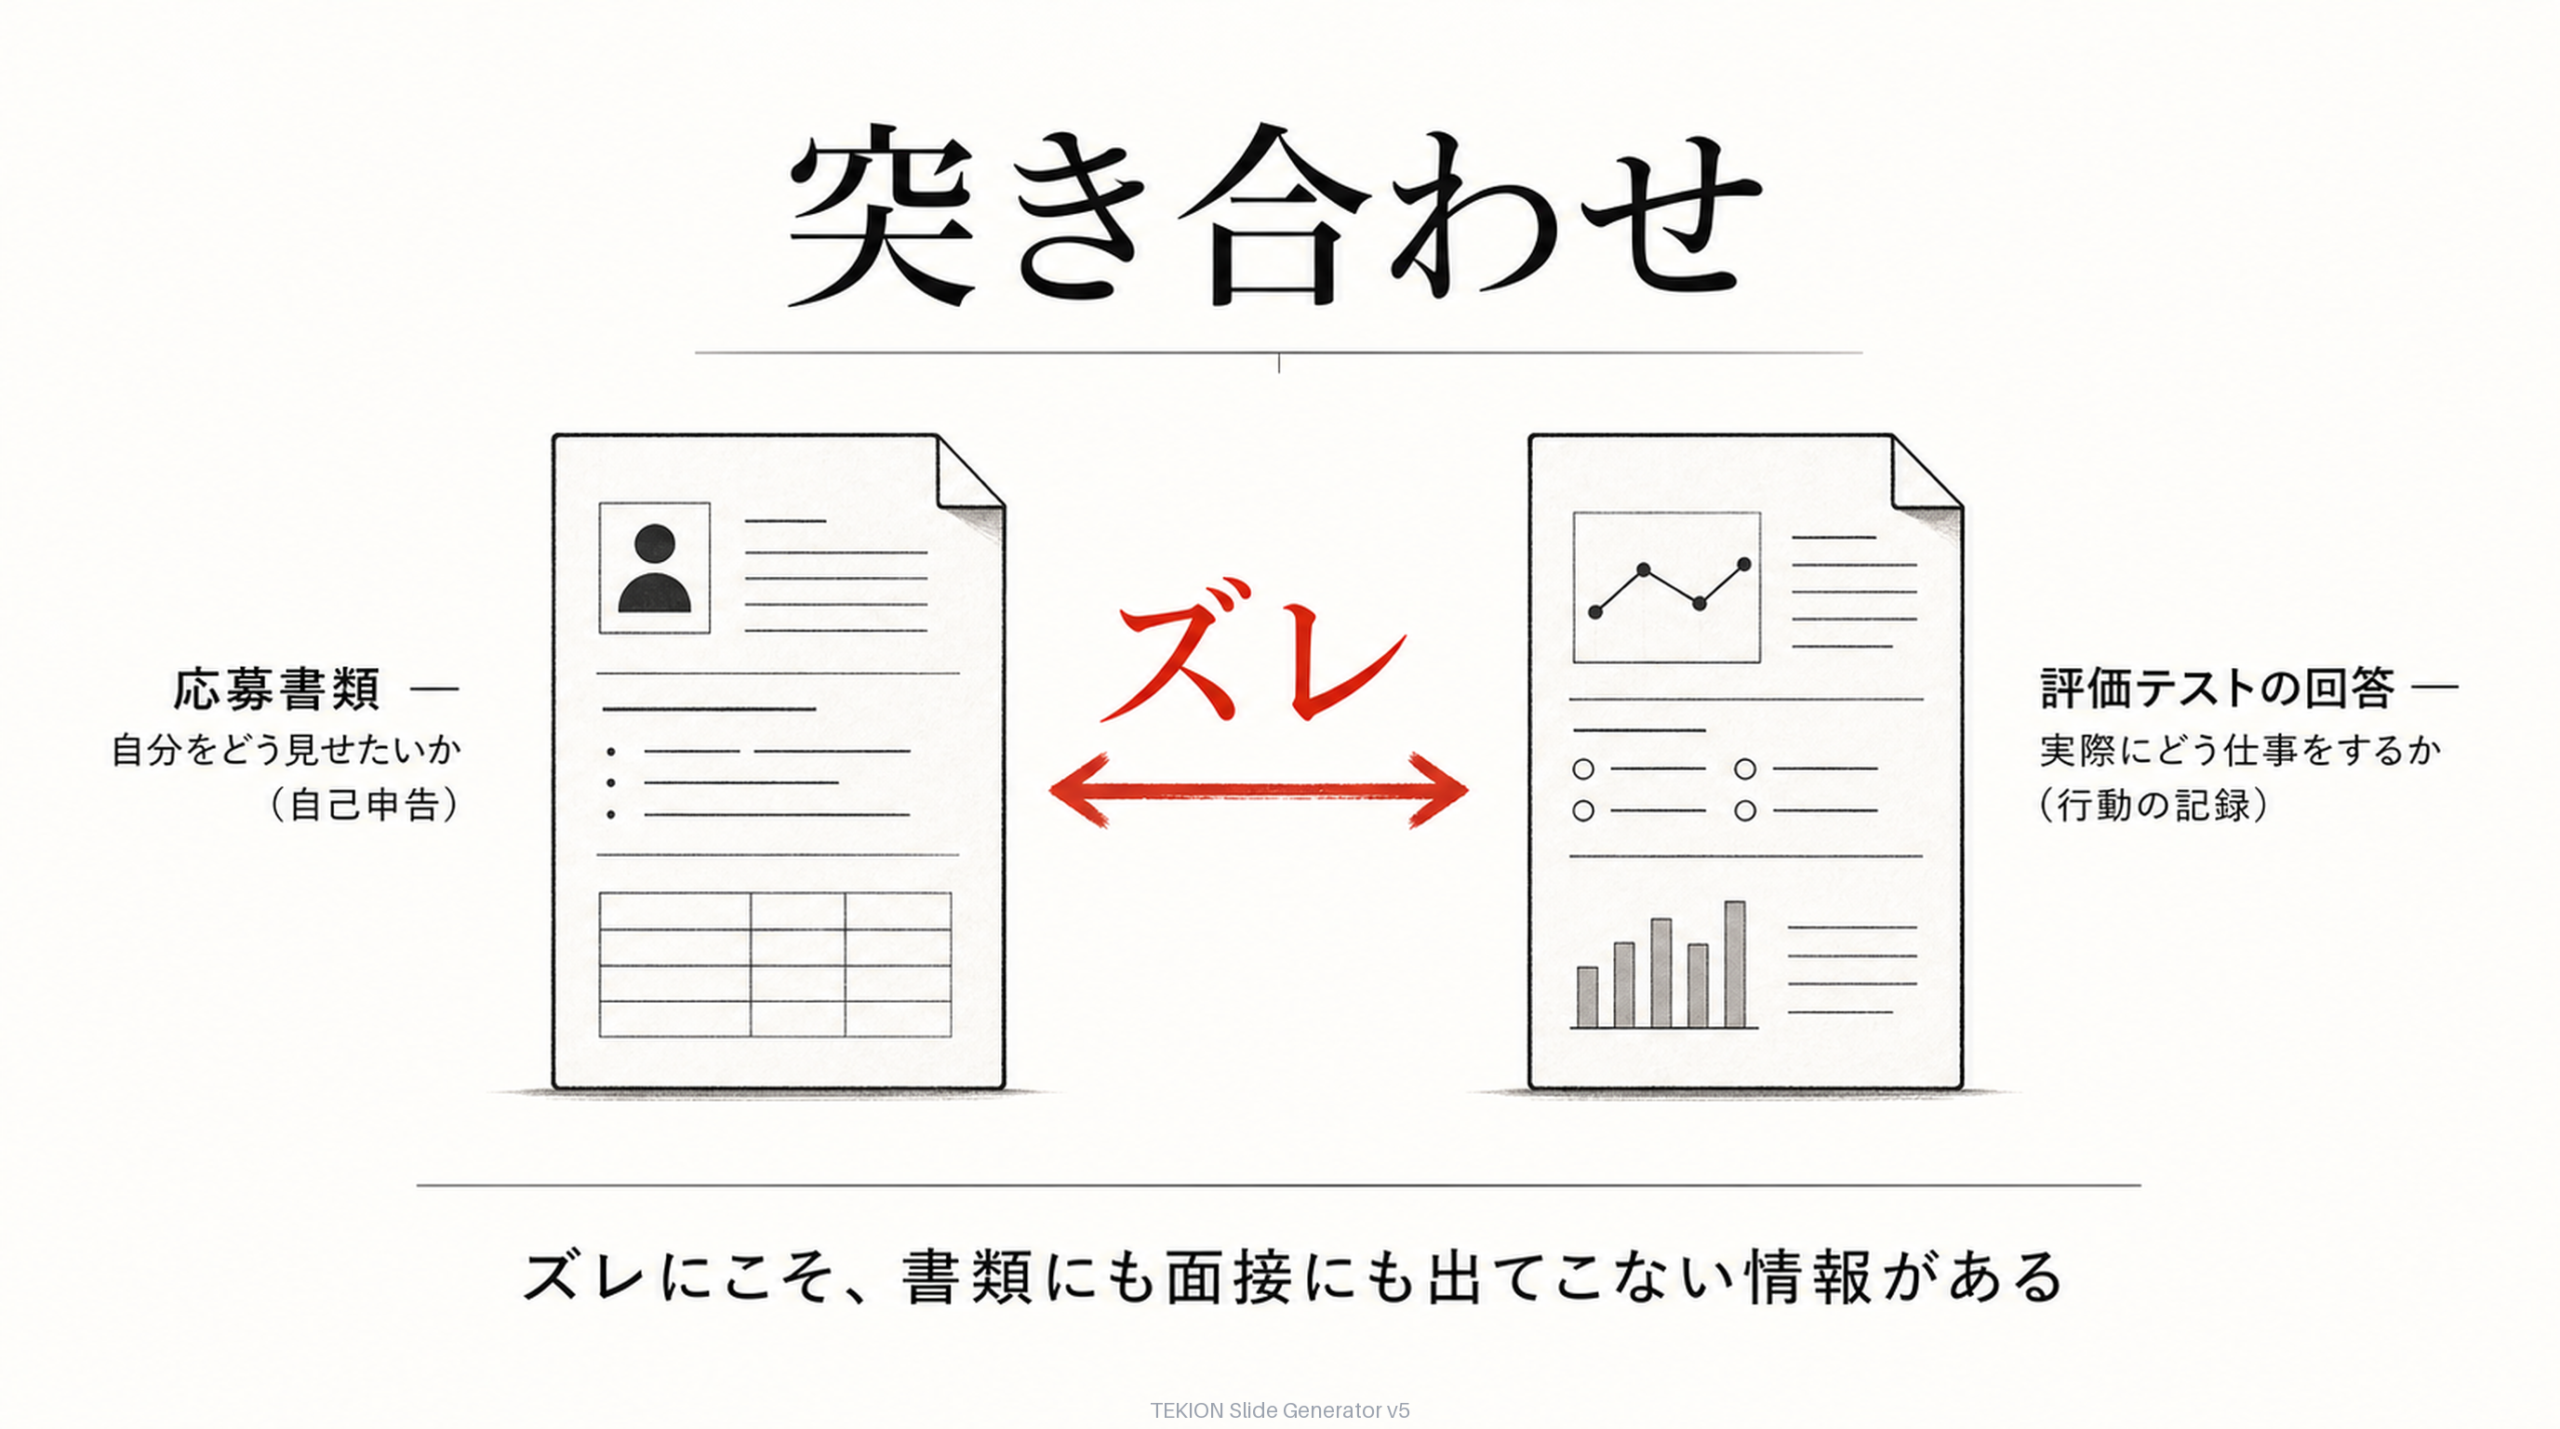
応募書類は「自分をどう見せたいか」という自己申告。評価テストの回答は「実際にどう仕事をするか」という行動の記録。この2つの間のズレにこそ、書類にも面接にも出てこない情報が詰まっています。
実際にあった例を、特定されない形で書きます。応募書類に「AIの出力は自分で振り返り、責任を持って対応している」と書いてきた方がいました。書類としては満点の記述です。ところが評価テストでは、AIのハルシネーションが混ざった出力を、そのままコピペして提出してきた。書いてあることと、やっていることが真逆だった。
書類だけなら通っていたと思います。テストだけでも「精査が甘い」で終わったでしょう。突き合わせたから、「言行のズレ」という情報になった。そしてこのズレの検出は、まさに生成AIが得意な仕事です。2つの文章を並べて「主張と行動が食い違っている箇所を挙げよ」と読ませる。数値データも学習済みモデルも要りません。
設計の一般形として言えば、こうなります。自己申告の文章と、行動の記録。この2系統が揃う業務は、突き合わせ設計ができる。
詳細化で決めた、残りの2つ
4ステップの詳細化として、技術選定のほかに決めたことを簡単に。
データの入り口を自前で設計する。突き合わせの片側である評価テストは、うちが設問を設計しています。つまり読ませるデータを、読みたいものが出るように作っている。ここが「あるものをAIに読ませる」との違いです。設問の実物は公開しませんが(評価装置なので)、設計の考え方は連載の捏造の回で書いたとおり。実務のシチュエーションを再現し、AI使用可にして、答えの個数を教えない。
AIの役割は「材料の生成」で止める。突き合わせで出てきたズレは、あくまで面接で確かめる論点のリストです。ズレがある=不採用、ではない。書類を盛るのは誰でも多少やることで、ズレの中身と程度を見極めるのは人の仕事。線引きの話(AIは材料、決めるのは人)が、ここでも効いています。
演習:データの棚卸しから技術選定まで
90分のワークにするなら、こうです。
手順
- 自社の業務データを思いつく限り書き出す(帳票、メール、報告書、録音、写真、そして「◯◯さんの頭の中」も含める)
- 4形状(数値/文章/画像/暗黙知)に仕分ける
- 文章のうち、「自己申告」と「行動の記録」のペアになりうる組み合わせを探す
- ペアが見つかったら、「突き合わせたら何が見えるか」を一行で書く
- 暗黙知に分類されたものについて、「誰の、どの判断か」を特定する(それが次の言語化テーマ)
評価の観点
- 「データがない」と言っていた人が、文章と暗黙知の在庫に気づけたか
- 技術の名前(どのAIを使うか)より先に、データの形状の話ができているか
- 突き合わせの発想が出ているか(単体処理の高速化で止まっていないか)
まとめ
- 「データを集めて予測」は中小企業では死ぬ。学習に足るデータが貯まっていないから
- データは4形状:数値/文章/画像/暗黙知。中小企業に豊富なのは少数の濃い文章と暗黙知
- だから技術選定はほぼ自動的に生成AIになる。流行ではなく、データの形状からの逆算
- 単体処理より突き合わせ。自己申告と行動記録のズレには、書類にも面接にも出ない情報がある
- 読ませるデータの入り口を自前で設計する。AIの役割は材料の生成で止める
これまでの記事:第1回/第2回/第3回/第4回/第5回/第6回 効果の測り方4層
次回からケースが変わります。採用の次は営業のダッシュボード。「SaaSを買う」でも「高いプランに上げる」でもなく、業務に合う道具を自分たちで作った話です。ただし先に言っておくと、作ること自体は簡単でした。難しかったのは、その手前にある地味な話です。
投稿者プロフィール

Consultation
記事の内容を、自社の課題に置き換えて整理しませんか。
現状整理から、必要な取り組みと進め方を一緒に考えます。
相談してみる